Изображения и PDF
JPG, PNG, WEBP, BMP, TIFF и PDF. Многостраничные TIFF и PDF обрабатываются постранично в исходном порядке.
Пользователь отправляет фото, скан или PDF в Telegram или на почту и получает текст или редактируемый DOCX — с заголовками, абзацами, порядком чтения и таблицами вместо картинки, которую нужно перепечатывать.
Собственный инструмент, не клиентский заказ. Запущен в production для разрешённых отправителей — публичного доступа нет. Схема и пример документа на странице — иллюстрации на вымышленных данных, не скриншоты.
Каналы — только адаптеры, распознавание и выбор формата ответа — в общем сервисе. Схема по ARCHITECTURE.md.
Задача
Заявки, письма, таблицы и договоры часто приходят фотографией или сканом. Чтобы поправить текст или пересчитать таблицу, его перепечатывают вручную.
Задача — получить редактируемый документ с исходной структурой: заголовками, абзацами, порядком чтения и таблицами. А короткий текст — сразу в ответе, без файла.
Архитектура
Telegram и Email — только адаптеры: принимают файл, проверяют отправителя и отдают результат. Распознавание, модель документа и выбор формата ответа живут в DocumentOCRService и не зависят от канала.
PDF с пригодным текстовым слоем читается через PyMuPDF без повторного OCR, сканированные страницы уходят в Yandex Vision. Ответ провайдера переводится в независимую Document Model, из неё OutputPolicy делает короткий текст или DOCX.
Реализовано
JPG, PNG, WEBP, BMP, TIFF и PDF. Многостраничные TIFF и PDF обрабатываются постранично в исходном порядке.
Если в PDF есть пригодный текст, он извлекается локально. В OCR уходят только сканированные страницы.
Абзацы, заголовки, порядок чтения и геометрия OCR-блоков сохраняются во внутренней модели документа.
Нативные таблицы Yandex Vision становятся редактируемыми таблицами DOCX, включая пустые и объединённые ячейки. Восстановление по видимой сетке через OpenCV — опционально и выключено по умолчанию.
Короткий текст до 2 500 символов приходит сообщением или в теле письма, таблицы и длинные документы — файлом DOCX. В Telegram есть кнопка «Получить DOCX».
Allowlist отправителей, защита от повторной обработки, состояние почтовой доставки в SQLite, лимиты на размер файла и число страниц.
Результат
Иллюстрация на вымышленных данных: скан заявки и DOCX с заголовком, абзацами и таблицей. Не результат реального распознавания.
Результаты
Из отчётов о разработке и запуске в репозитории.
Проверка в production — ручная, со стороны оператора. Она подтверждает работу каналов, а не измеряет точность распознавания.
Ограничения
Ещё в разделе «AI-решения»
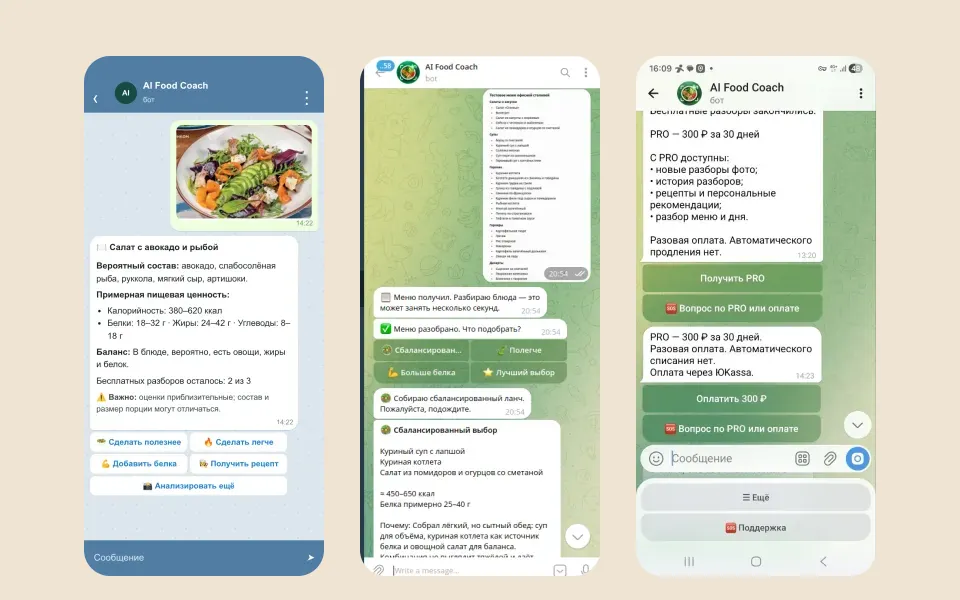
Production Telegram-сервис с multimodal AI, подпиской, платежами, поддержкой, web-admin и аналитикой.
AI-консультант по товарному каталогу с RAG, structured retrieval, evaluation и контролем качества: факты берутся из каталога, а не из памяти модели.
Telegram-бот, который принимает обращение текстом, голосом, изображением или документом, уточняет недостающие детали и передаёт менеджеру структурированную заявку.
Связанные направления
Нужен похожий проект?
Подключу OCR к каналу, куда документы уже приходят, — Telegram, почте или веб-форме — и настрою выдачу в нужном формате с проверкой качества на ваших образцах.