Три формата документов
PDF с метаданными и номерами страниц, HTML-страницы wiki и текстовые инструкции в одном индексе.
Сотрудник задаёт вопрос обычным языком, а ассистент ищет ответ в регламентах, wiki-страницах и инструкциях, указывает документ и страницу — и отказывается отвечать, если подтверждения в документах нет.
Учебный R&D-проект курса OTUS «LLM Engineering», не клиентский заказ. Корпус — 33 синтетических документа вымышленной технологической компании, реальные корпоративные документы не использовались. Схемы и пример ответа на странице — иллюстрации, не скриншоты продукта.
От документов до ответа с цитатами или «Я не знаю». Схема по README репозитория.
Задача
В корпоративной базе знаний — регламенты в PDF, wiki-страницы и текстовые инструкции. Одно правило встречается в нескольких документах, рядом лежат действующие и архивные редакции, похожие категории и идентификаторы.
Задача — ассистент, который отвечает только по документам, показывает, откуда взят каждый факт, учитывает редакции и честно говорит «Я не знаю», когда подтверждения нет.
Архитектура
Документы разбираются по формату: PDF — через PyMuPDF с номерами страниц, HTML — через Beautiful Soup, TXT — как есть. Чанки получают метаданные, в поиск попадают только действующие редакции.
Dense-поиск (BGE-M3 в Qdrant) и BM25 работают параллельно, результаты объединяет Reciprocal Rank Fusion. Cross-Encoder переупорядочивает 20 кандидатов, в контекст модели идут 5. Ответ проходит проверку цитат и отдельный GroundingVerifier.
Реализовано
PDF с метаданными и номерами страниц, HTML-страницы wiki и текстовые инструкции в одном индексе.
В поиск попадают только документы со статусом active: архивная политика с устаревшим сроком не участвует в ответе.
Dense на BGE-M3 и BM25, который разбивает составные идентификаторы на части. Списки объединяются через RRF.
Cross-Encoder переупорядочивает 20 кандидатов, в контекст модели попадают 5 самых релевантных фрагментов.
Модель ссылается на [SOURCE_n], после проверки ссылки превращаются в «документ, страница PDF».
Отдельный вызов модели проверяет каждое утверждение: supported, unsupported или insufficient_evidence. Неподтверждённый ответ заменяется на «Я не знаю».
Формат ответа
Вопрос, ответ со ссылками [1] и [2], источники и проверка утверждений. Документы и формулировки придуманы для иллюстрации.
Результаты
Цифры — из результатов в репозитории. Набор небольшой, а эталоны были доступны во время разработки, поэтому это не независимая слепая оценка.
Тесты: 48 passed по последнему зафиксированному прогону pytest — обработка документов, чанкинг, BM25, цитирование, grounding-проверка и правила системного промпта.
Разбор ошибок
Главный результат — не только пайплайн, но и проверка того, где он ошибается.
| Что произошло | Что сделано |
|---|---|
| Требования к согласованиям категории C3 перенесены на изменения HIGH без подтверждения в документах | Регрессионный тест на сохранённом ответе: из 5 утверждений 2 — insufficient_evidence, ответ заблокирован |
| В ответ о процедуре PERMIT-7 попали сведения о другой процедуре — SAF-PERMIT-07 | Уточнён системный промпт; повторная проверка дала правильное определение и успешный grounding |
| Hybrid RRF без reranker уступил Dense по Hit@1: 0,385 против 0,462 | Reranker поднял Hit@1 до 0,615: гибридный поиск сам по себе не гарантирует улучшения |
Ограничения
Ещё в разделе «AI-решения»
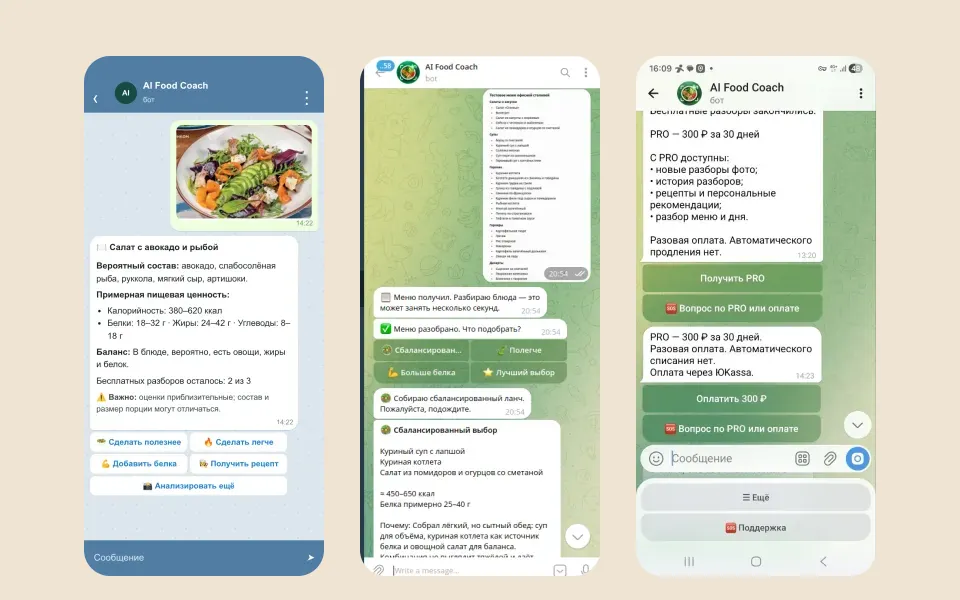
Production Telegram-сервис с multimodal AI, подпиской, платежами, поддержкой, web-admin и аналитикой.
AI-консультант по товарному каталогу с RAG, structured retrieval, evaluation и контролем качества: факты берутся из каталога, а не из памяти модели.
Telegram-бот, который принимает обращение текстом, голосом, изображением или документом, уточняет недостающие детали и передаёт менеджеру структурированную заявку.
Связанные направления
Нужен похожий проект?
Спроектирую поиск по вашей базе знаний с цитатами, учётом редакций и проверкой обоснованности — и измерю качество на ваших вопросах до запуска.